

O custo de uma resposta de inteligência artificial pode diminuir à medida que a conta do usuário aumenta. Entre assinatura, volumes de texto processados, pesquisas e repetições, o preço exibido não é suficiente para medir o orçamento. As taxas oficiais consultadas em 10 de novembro de 2026 permitem que essas despesas sejam repartidas, sem confundir uma resposta barata com um trabalho devidamente concluído.
Apósramprocessadoreseconta de luzA série de preços trata de uma despesa menos visível: a do software que consome cálculo em cada uso. Para uma empresa independente, uma pequena empresa ou uma associação, a questão prática é o que permanece incluído no pacote e o que varia com a atividade.
De 2022 a 2024, um declínio no desempenho definido
LÍndice AI Stanford 2025, publicado em 7 de abril de 2025, fornece uma referência histórica: o custo de questionar um modelo atingindo GPT-3,5 no teste MMLU aumentou de $20 por milhão de fichas em novembro de 2022 para $0,07 em outubro de 2024. O limiar é 64,8% correto. O ponto final é Gemini-1,5-Flash-8B.
| Período | Dólares por milhão de fichas |
|---|---|
| Novembro de 2022 | 20.00 |
| Outubro de 2024 | 0, 07 |
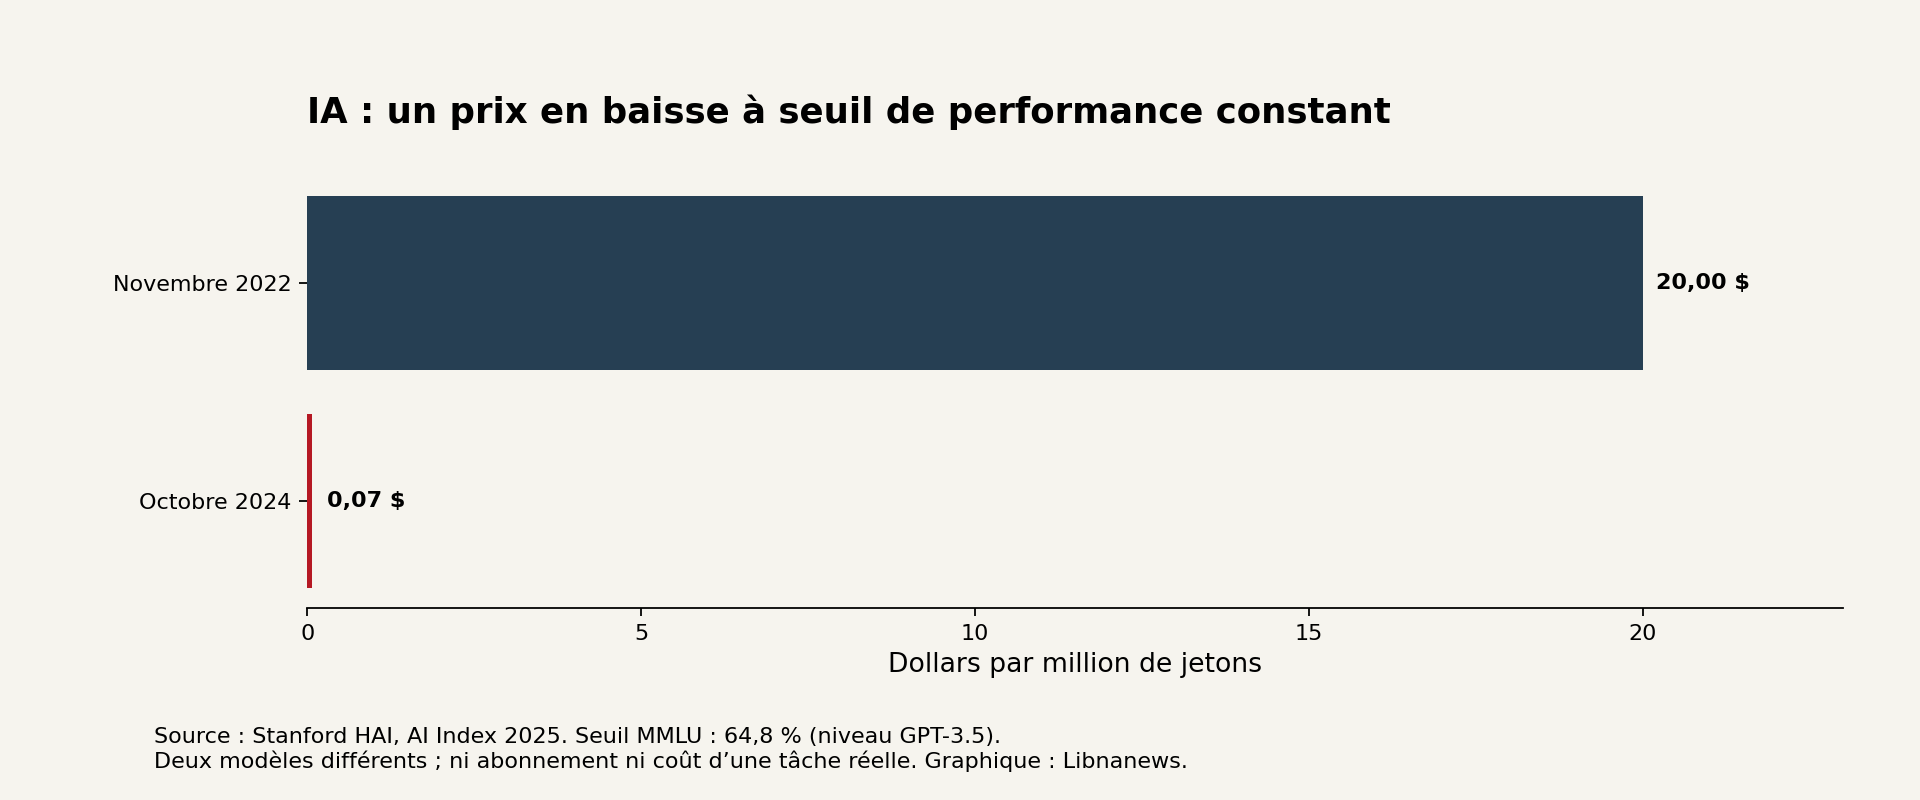
Trata-se de duas observações num determinado limiar de desempenho, e não do preço do mesmo produto mantido durante dois anos. Eles não medem o preço de uma assinatura ou o sucesso de um agente em uma empresa. A relação excede 280, mas não pode ser estendida até 2026 sem manter o mesmo método. As taxas atuais abaixo são, portanto, uma segunda tabela, separada desta série histórica.
A assinatura e o consumo não pagam o mesmo
Num pedido, uma subscrição dá acesso a funções e capacidade de utilização. Uma API é uma interface que permite que outro software consulte o modelo; seu consumo é geralmente contado. Uma empresa que automatiza o processamento de documentos deve, portanto, ler as condições da API, mesmo que seus funcionários já tenham uma assinatura.
Agrelha Claudeilustra esta distinção: Pro é exibido em $20 por mês em pagamento mensal, ou $200 pagos com antecedência para o ano. Max custa $100 por mês e Ultra $200, excluindo impostos aplicáveis. Os limites de utilização permanecem; A quantidade consumida depende, em particular, do modelo, da duração das conversas e dos arquivos.
No entanto, seria incorrecto afirmar que ambas as facturas continuam completamente separadas. Antrópico agora planejacréditos da API para assinantes selecionados: 100 dólares mensais para Max e 200 para Ultra, sob condições de ativação. Eles expiram no final do ciclo e não se referem. Eles não cobrem Claude Code, excedências em aplicações Claude, ou plataformas parceiras. Por conseguinte, o seu montante não constitui um desconto universal em todas as utilizações da marca.
Um cesto idêntico de fichas, não uma promessa do mesmo resultado
Um token é uma unidade de texto processada pelo modelo, não necessariamente uma palavra. A entrada compreende o que lhe é transmitido; a saída corresponde à sua produção facturada. Para tornar as tarifas legíveis, o quadro seguinte aplica os preços de base a um cabaz meramente ilustrativo: um milhão de fichas de entrada sem cachos e 200.000 fichas de saída billable, combinados em várias consultas curtas. Exclui ferramentas, impostos, créditos promocionais, modos acelerados e tratamentos de longo prazo aumentados.
| Modelo | Entrada por milhão | Produção por milhão | Custo do cabaz |
|---|---|---|---|
| Luna GPT- 6 | 0,10 | 0, 50 | 0,20 |
| Solo GPT-6.1 | 2.00 | 10.00 | 4,00 |
| Claude Sonnet 5.5 | 2.00 | 10.00 | 4,00 |
| Claude Opus 5.5 | 4,00 | 20.00 | 8.00 |
| Claude Fable 5.2 | 8.00 | 40.00 | 16.00 |
Quantidades provenientes de redesOpenAI, modo padrão e contexto curto, eTaxas básicas antrópicas. O cálculo é de entrada + 0,2 × saída. Dois preços idênticos não significam dois modelos intercambiáveis. O mesmo documento também pode produzir um número diferente de chips dependendo do modelo. Esta simulação compara unidades carregadas; não classifica a precisão, a velocidade ou o custo de um arquivo realmente concluído.
Por que as respostas longas pesam mais
Na cesta de $4, entradas custam $2 e sai $2. No entanto, há cinco vezes menos fichas. A estas taxas, exigir uma produção mais longa muda rapidamente a despesa. Se a saída aumenta de 200.000 para 400.000 moedas, com a mesma entrada, o total atinge $6, um aumento de 50%. Este é um cálculo do cenário, não uma factura observada.
Pesquisas podem ser adicionadas. Em particular, a grade OpenAI exibe $10 por 1.000 chamadas padrão de busca na web, além de faturamento do conteúdo de busca transmitido ao modelo. Mil buscas, portanto, não são confundidas com mil respostas textuais simples. Uma ferramenta que verifica várias páginas, reformula e repete pode multiplicar estações de consumo antes de entregar alguns parágrafos.
Reutilização de um documento pode reduzir o seu rebilling
Ainstruções de cache e documentosevitar recalcular certos elementos já tratados. Trata-se de uma parte comum situada no início do pedido, que deve ser idêntica. Manter uma conversa por si só não garante que esta redução se aplique.
Para o GPT-6.1 Sol, a taxa de leitura do cache é de $0,10 por milhão de fichas, em comparação com $2 para uma entrada comum. Mas a escrita inicial no cache também tem um preço: $2,50 com o tempo de armazenamento padrão de trinta minutos. Comparando apenas $0,10 a $2 eliminaria esta primeira despesa.
Exemplo simplificado: A mesma porção de 100.000 token, totalmente reutilizável, custa $0.25 para escrever e $0.09 para nove leituras. O total é de $0,34, em comparação com $2 para 10 salários regulares. Este cálculo exclui saídas e novas informações adicionadas; assume nove reutilizações bem sucedidas antes de expirar. Ele não descreve o preço de uma conversa inteira.
Esperar pode custar menos
A velocidade é outra escolha económica. LLote da API OpenAIoferece uma redução de 50% das chamadas síncronas, com uma janela de processamento de 24 horas. O fornecedor é responsável, em especial, pela classificação de grandes conjuntos e avaliações.
Para uma empresa que apresenta os seus documentos à noite, este período pode ser aceitável. Para um serviço que responde imediatamente a um cliente, ele muda o serviço prestado. O montante mais baixo paga, portanto, outra restrição de entrega. Todas as reduções anunciadas não devem ser adicionadas mecanicamente sem verificar se o modelo e o modo escolhidos as permitem.
O denominador certo: a tarefa devidamente concluída
Na suaguia de otimizaçãoAnthropic recomenda comparar o custo por tarefa concluída em vez do único preço token. Um modelo mais unitário pode reduzir repetições; Por outro lado, usar o mais caro para cada classificação elementar pode desnecessariamente aumentar o orçamento. Os resultados apresentados pelo fabricante permanecem únicos nos seus ensaios e não substituem um ensaio nos documentos do cliente.
O método concreto consiste em pegar uma amostra estável, definir o que é uma resposta aceitável e, em seguida, identificar consumo, erros e correções. Arquivos difíceis devem permanecer nesta amostra. Removê-los melhoraria artificialmente o custo médio e mascararia precisamente os casos que mais exigem trabalho.
OpenAI identifica três alavancas na suaguia de redução de custos: limitar o número de consultas, reduzir volumes de texto e escolher um modelo menor quando a precisão é suficiente. Para o leitor, isso se traduz em perguntas simples: você tem que devolver o arquivo completo, obter dez páginas em vez de uma síntese, ou reiniciar toda a tarefa para uma única correção?
O orçamento a seguir inclui várias linhas: possível soma fixa, consumo líquido após créditos realmente utilizáveis, ferramentas e, em seguida, tempo de auditoria humana. Não existe uma escala pública para atribuir um preço universal a esta última linha. É precisamente por isso que um preço por milhão de fichas, mesmo muito baixo, não se permite prometer uma economia no trabalho final.

Comentários